

导读:腾讯 ima 的知识库数量达千万级,ES 侧数据规模接近千亿级,这样的体量下,「一套引擎同时承载全文、向量与混合检索」不是口号,而是每天要面对多租户隔离、极端长尾分布、查询扇出与内存成本的真问题。在 腾讯云 × Elastic AI 搜索技术大会上,腾讯 ima 高级工程师王志铭发表《腾讯 ima 基于 ES 的 AI 知识库技术架构实践》演讲,从选型逻辑、检索特性到千亿规模的三大挑战,完整分享了 ima 的实战解法。
什么是AI知识库
传统知识库是关键词匹配 + 人工分类 + 被动查询 + 手动维护;AI 知识库是语义向量检索 + RAG、自动向量化与多模态组织、自然语言问答直接给答案、实时同步自动学习。用一句话概括:AI 知识库 = 大模型 + RAG 检索——用自然语言提问,从文档中召回相关片段并直接生成答案,替代人工翻找。
ima 的场景分两类:一是 RAG 检索增强生成链路,基于问题找到相关内容;二是文档内容搜索,满足标题、标签等元数据的多样化全文检索诉求。
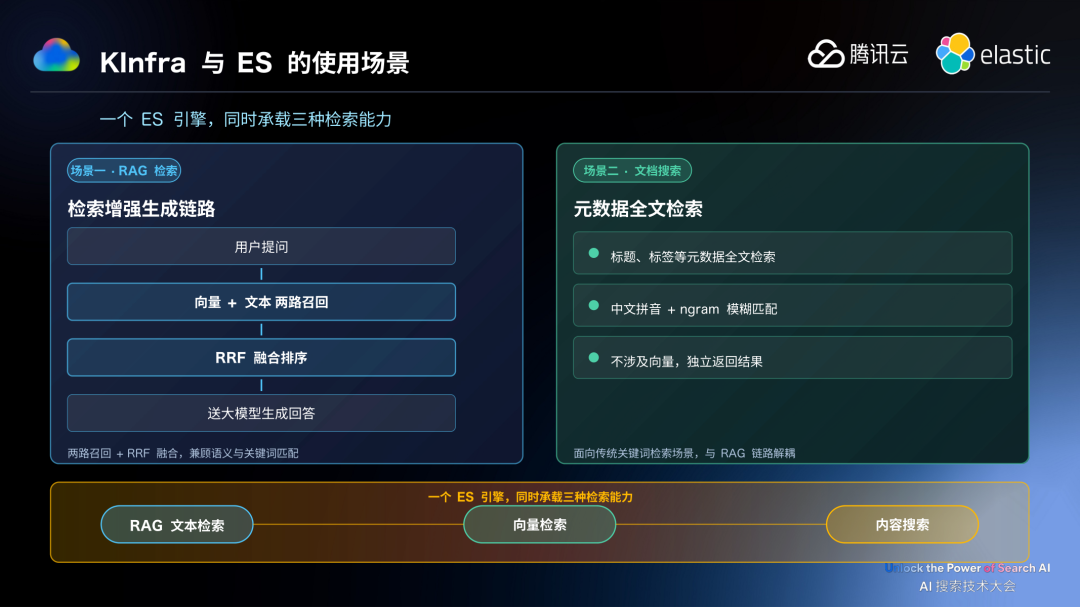
一个 ES 引擎,同时承载三种检索能力
整体架构:一套引擎承载三种检索
ima 的整体架构分四层:
- 应用层(RAG 智能问答、内容搜索)面向用户;
- 入库层负责文档处理与向量化流水线——文档解析(PDF/Word/HTML)→ 智能分块 → Embedding → 写入;
- 检索层负责双路召回与混合融合——RAG 链路走 Text BM25 + Vector KNN 再 RRF 融合,内容搜索链路走 BM25 + 分析器(拼音/模糊/高亮);
- 存储层由 Elasticsearch 统一支撑文档、向量与倒排索引。
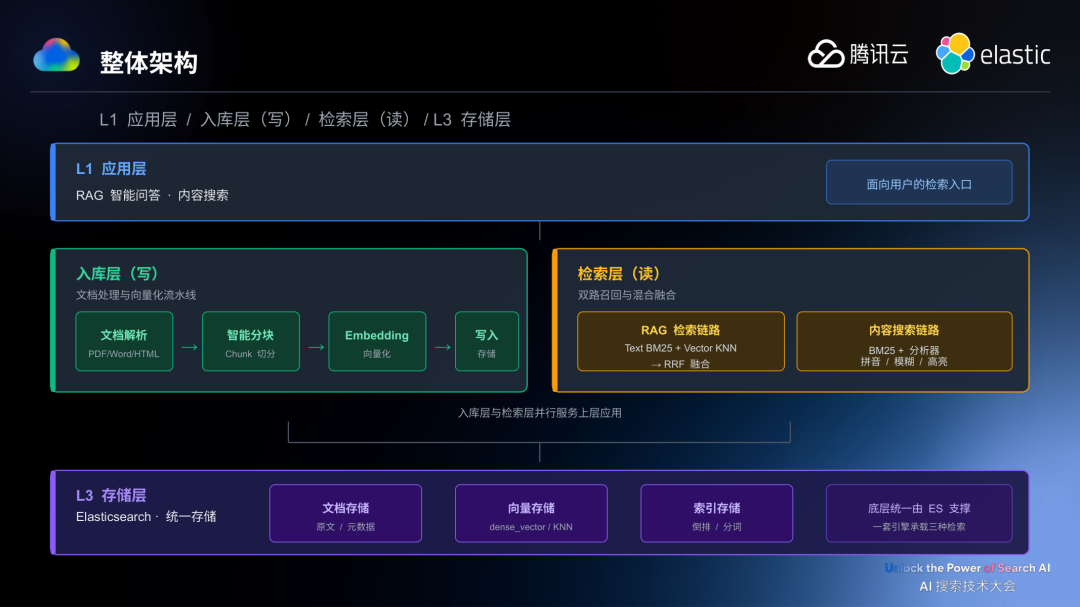
ima 整体架构:入库层与检索层并行,ES 统一存储
为什么选 ES?答案可以归为七个原因:一套引擎两种检索(dense_vector + BM25,免维护两套系统)、原生向量能力(HNSW/BBQ,无需外挂向量库)、原生混合检索(RRF Retriever 开箱即用)、灵活中文支持(自定义 analyzer + multi-field)、大规模友好(多集群/索引/分片弹性扩展)、成熟稳定的生态,以及——腾讯云 ES 团队的深度协作:ima 业务发展中的很多问题排查与业务诉求,都与腾讯云 ES 团队紧密联动,ES 的很多能力也正是在这样的真实业务诉求中打磨出来的。结论很直接:腾讯云 ES 是 AI 知识库的最佳底座。
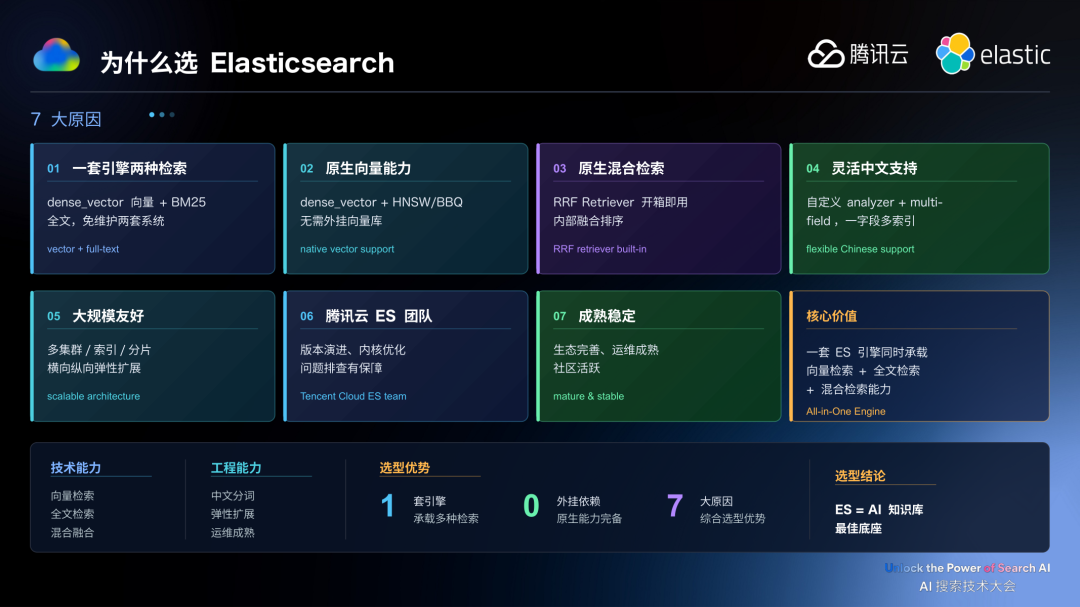
选型结论:ES = AI 知识库最佳底座
检索实践:把ES特性用足
文档检索侧,ima 用足了腾讯云 ES 的检索特性:拼音搜索(自定义 analyzer 将中文转拼音,输入「zhishi」或「zs」命中「知识」)、模糊搜索(ngram 单字切分,支持前缀/子串匹配)、multi-field 多字段映射(标题同时映射 keyword/text/pinyin/ngram,一次写入多种检索并行可用)、关键词高亮(原生 highlighter 无缝接入前端)。业务发展会不断冒出新检索诉求,ES 成熟的搜索生态让每一种都能稳稳接住。
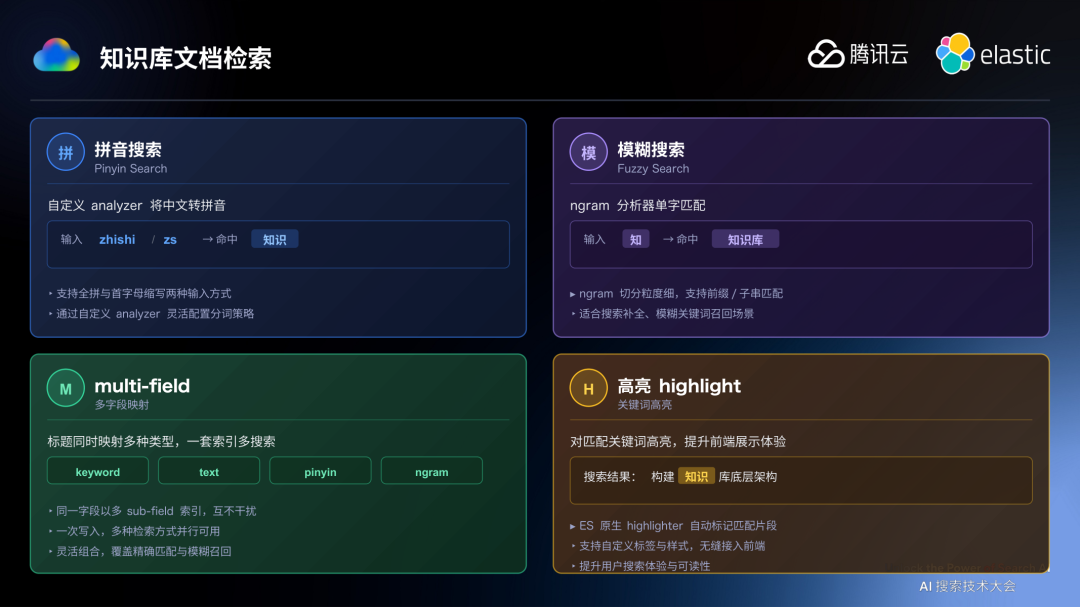
拼音、模糊、多字段、高亮:文档检索的 ES 特性
RAG 检索侧,完整链路是:用户 Query → Query 改写(多 query 扩展)→ 两路召回(Text BM25 + Vector KNN,稀疏 + 稠密互补)→ RRF 融合(ES 原生能力,无需自研融合逻辑)→ Top-K 截断 → 送大模型生成。RRF 的思想朴素而有效:一篇文档如果在每一路召回中排名都靠前,融合后排位自然最前——「法国和巴黎」这种强语义关联,关键词匹配捕捉不到,向量召回补位。
向量召回上,dense_vector 字段配合 BBQ 量化有两种选型:bbq_hnsw(量化 + HNSW 图,内存优先、低延迟)与 bbq_disk(量化落盘,规模优先、支撑更大向量)。KNN with filter 让向量检索时直接叠加 uid/知识库 ID 过滤,不再「先全量召回再过滤」,召回效率与精度同步提升。
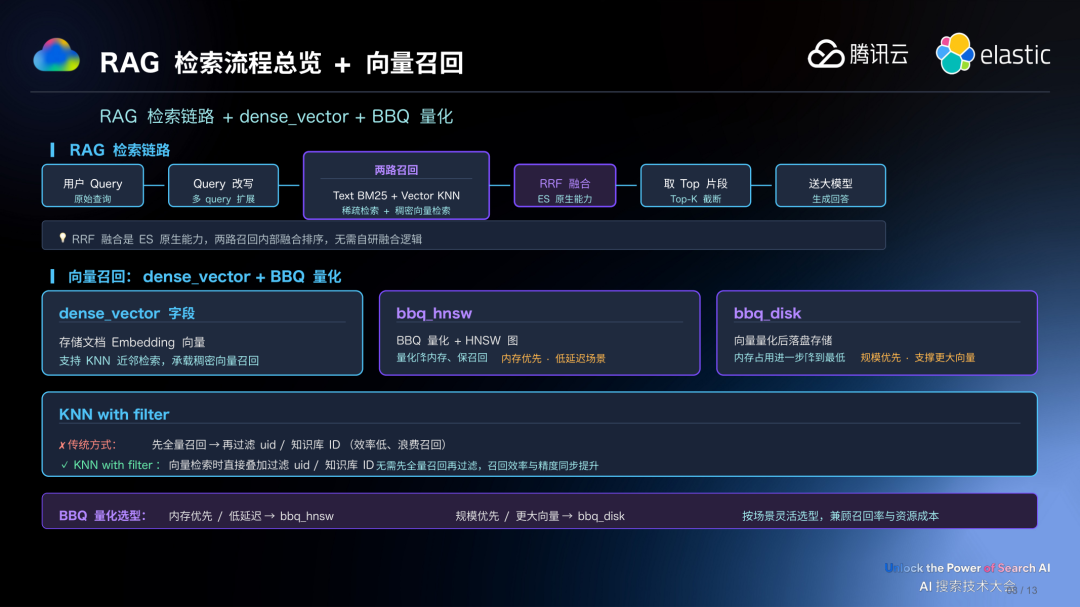
RAG 检索链路:两路召回 + RRF 融合 + BBQ 量化选型
千亿规模的三大挑战与解法
AI 知识库场景有三个鲜明特征:
- 多租户严格隔离(检索本质是在指定知识库子数据集内完成,不是全量扫描);
- 数据分布极端(总量大、租户极多,多数知识库只有几十几百个文档,极端单库可达几千万甚至上亿);
- QPS 均摊极低且反复激活(总 QPS 高,但落到单个知识库不到 1,冷数据被反复加载又挤出)。
由此引出三大挑战:
挑战一:数据无限膨胀 → 横向 + 纵向双重扩展。
横向,多集群 + 多索引路由,按 tenant_id 分段归属到具体 (cluster, index),突破单集群上限;纵向,索引 alias + rollover——写入指向别名,超过阈值滚动生成新索引,旧索引继续可查,单库数据量涨到几亿也不慌。业务视角只需知道「知识库在某个索引」,底层怎么变 ES 都帮忙解决了。
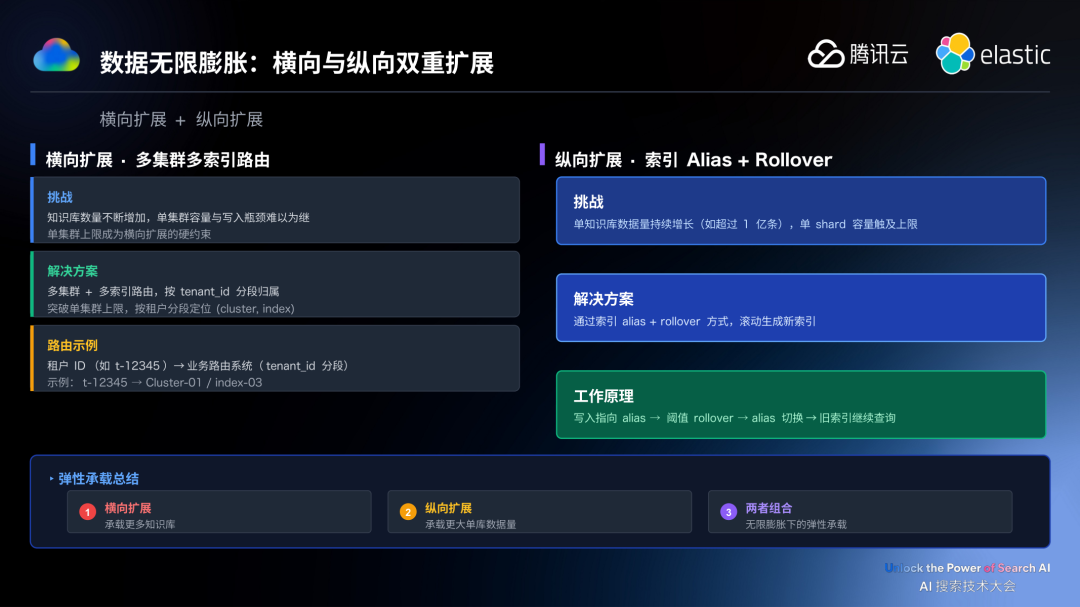
横向多集群多索引路由 + 纵向 alias rollover
挑战二:向量内存与存储压力 → bbq_disk 是最优解。
知识库像云盘,「大家都喜欢买书但不一定喜欢看书」——存储需求无限增长,内存不能。基于内存的索引一旦跟不上数据增长就明显劣化;冷热交替的访问特征又让内存很难发挥优势。数据无限增长、成本有限——基于磁盘的 bbq_disk 在这个场景下是性能与成本的最优解。 配合 _source excludes 向量字段(检索不依赖原向量),还能省下约一半的冗余存储与 IO。
挑战三:查询扇出与分片热点 → 自定义路由 + bbq_disk slice。
单知识库几万条数据散落到几百个 Shard 会产生严重扇出;用 _routing 按知识库 ID 路由只命中相关 Shard,再用 routing_partition_size 把大租户分散到多 Shard 消除热点。更进一步,在 ima 与腾讯云 ES 团队的协作下推进了 bbq_disk slice 的落地:检索和写入以 Shard 为粒度,搜自己知识库时本不必扫同 Shard 其他人的数据——按 tenant_id 在 Shard 内细分 slice、独立聚类,实现租户级隔离检索。实测收益:内存优化约 -71%,检索最佳 QPS 提升 58%+。
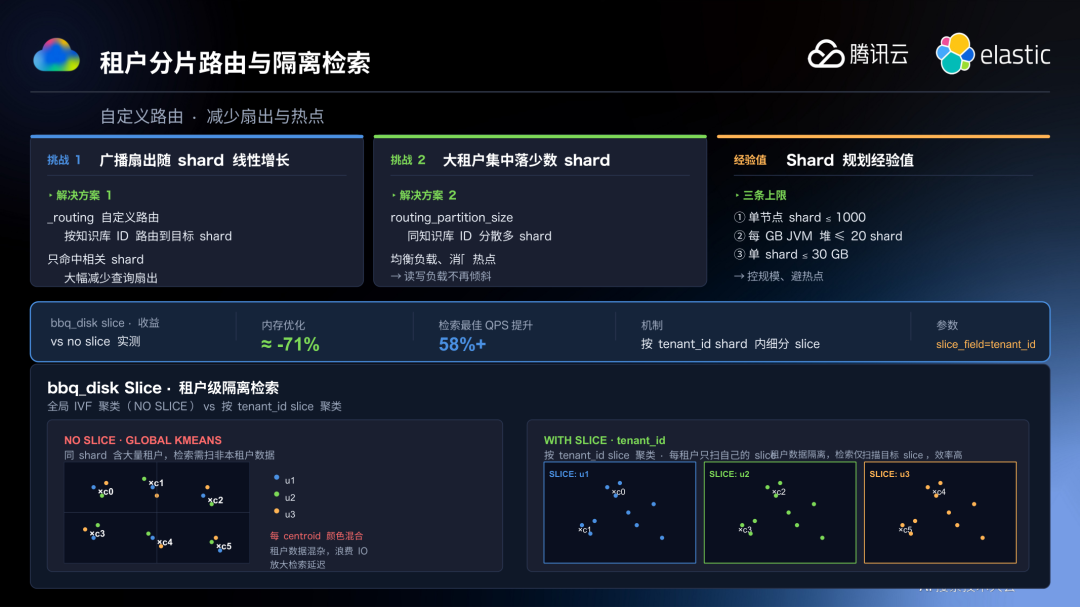
bbq_disk Slice:按 tenant_id 的租户级隔离检索
结语
腾讯 ima 的实践有一条清晰的方法论:每一项技术决策都建立在场景事实之上——多租户隔离、极端长尾、低均摊 QPS、冷热交替——方案由此推导而来。把特征看清,把腾讯云 ES 的原生能力用足,再与云服务团队共建缺的那一块,千万级知识库与近千亿级数据规模的底座就跑稳了。
END